

فونتهای Decoy؛ تلاشی برای گمراهکردن رباتهای هوش مصنوعی
طراحان و دانشمندان علوم کامپیوتر فونتهایی ساختهاند که برای انسان خوانا هستند، اما میتوانند خواندن متن را برای رباتهای هوش مصنوعی و مدلهای زبانی بزرگ دشوار کنند.
تهیهشده با کمک هوش مصنوعی از منابع ذکرشده · بازبینی و ویرایش: مهدی طالب لو · سیاست تحریریه
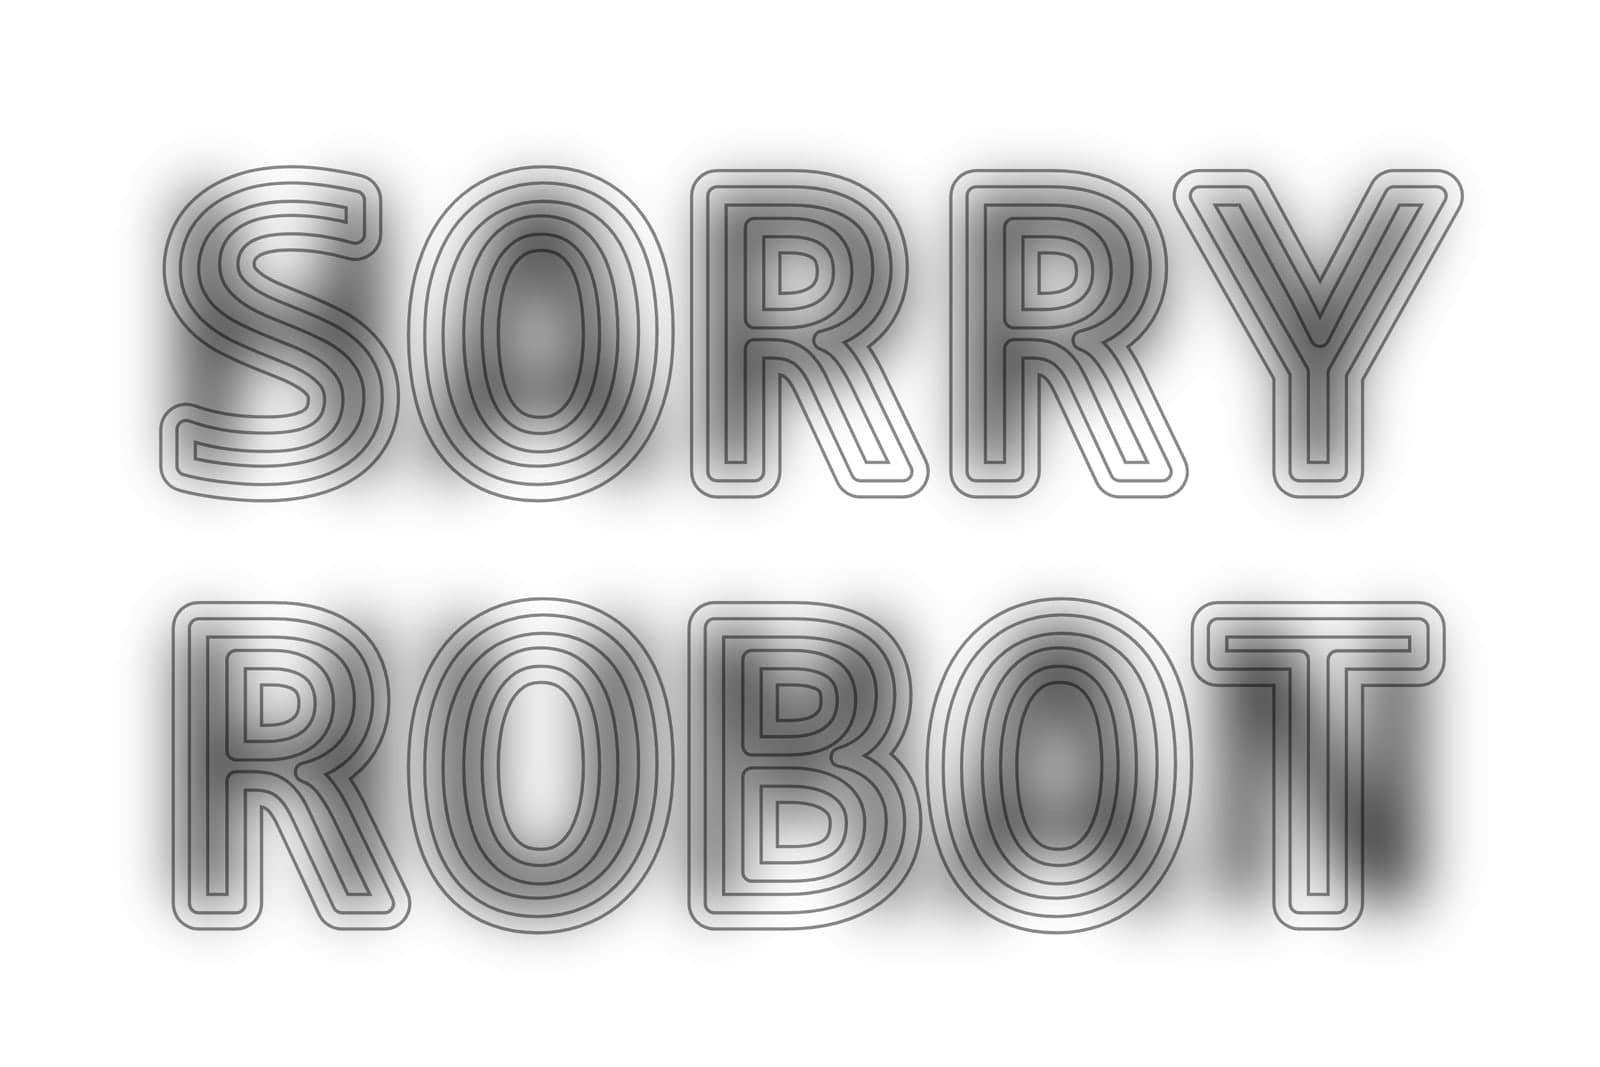
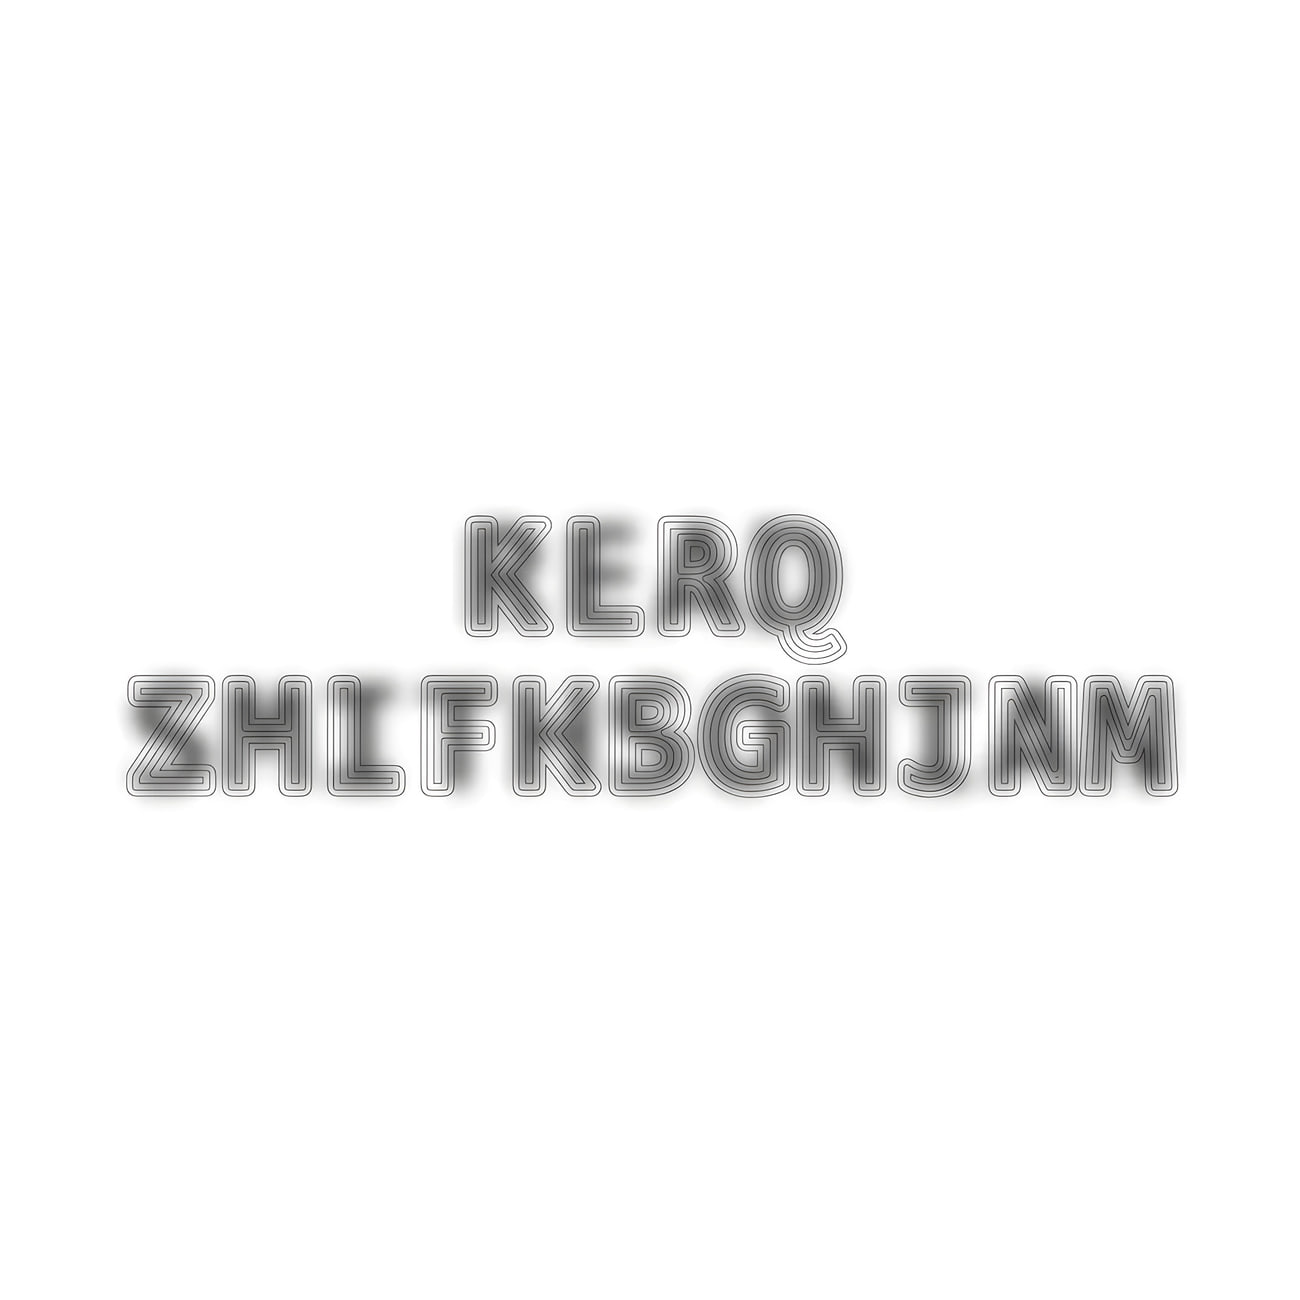
طراحان و دانشمندان علوم کامپیوتر تایپفیسهای تازهای با نام Decoy Font توسعه دادهاند که هدفشان جلوگیری از خزش خودکار رباتها و سرقت نوشتههای انسانی توسط مدلهای زبانی بزرگ است. این فونتها بهگونهای طراحی شدهاند که برای انسان خوانا باشند، اما سامانههای خودکار را به اشتباه بیندازند.
بر پایه اطلاعات منتشرشده، روش استتار بهکاررفته در این فونتها نسخهای مدرن از خطای دیدِ تصاویر ترکیبی است؛ روشی که پژوهشگران امآیتی در سال ۲۰۰۷ معرفی کرده بودند. در این شیوه، فونت از دو لایه متن تشکیل میشود: یک لایه با خطوط واضح در جلو قرار میگیرد و لایه دیگر بهصورت تار و تیره در پسزمینه دیده میشود تا خواندن متن برای سامانههای خودکار دشوار یا ناممکن شود.
اریک لو، بنیانگذار استودیوی میکسفونت، گفته است پس از مشاهده تلاش هوش مصنوعی برای خلاصهکردن پیامهای خصوصی او با مادرش، به فکر یافتن راههایی افتاد که امکان برقراری ارتباط را بدون خواندهشدن همهچیز توسط هوش مصنوعی فراهم کنند. او این تجربه را عاملی برای توجه به نفوذ فناوریهای خودکار در گفتوگوهای خصوصی دانسته است.
در نمونهای دیگر، استودیوهای Seneda & Abrucio و PlayType قلمی با نام ShieldFont عرضه کردهاند. این قلم نیمی از کلمات محتوایی، مانند اسمها، افعال و صفتها، را در کد منبع با واژههای تصادفی جایگزین میکند. طبق متن منبع، بیش از ۹۰ درصد متنهای نامفهومِ خروجی توسط فیلترهای کیفی هوش مصنوعی رد میشوند.
اریک لو همچنین گفته است که این پروژه ابتدا بهعنوان کاوشی درباره تلاقی هوش مصنوعی و تایپوگرافی آغاز شد، اما افزایش آگاهی درباره دسترسی و توانمندیهای روبهرشد هوش مصنوعی نیز از اهداف آن بوده است. به گفته او، واکنشها نشان میدهد افراد زیادی از حضور گسترده هوش مصنوعی خسته شدهاند و بهدنبال راهی برای دفاع از خود در برابر این فناوری هستند.
منابع خبر
- zoomit.ir — منبع اصلی
مطالب مرتبط
برای ادامه مطالعه
این یادداشتها بر اساس موضوع مشترک، همپوشانی برچسبها و تازگی انتشار انتخاب میشوند.
 تازه
Qwen3.8 با دستکاری یک نورون، پاسخهای خشونتآمیز تولید کرد
تقویت فقط یک نورون در مدل Qwen3.8 باعث شده پاسخهایش بهشدت خشونتآمیز و آزارگرانه شوند. نکته جالب این است که این تغییر موقتی بوده و رفتار عادی مدل را عوض نکرده است.
 تازه
شکایت از OpenAI بر سر توصیه پزشکی ChatGPT و مسئولیت پیامدها
یک خانواده از OpenAI شکایت کرده و میگوید ChatGPT به دخترشان توصیه کرده داروی تشنجش را مخفیانه کم کند و این موضوع را از پزشکان پنهان نگه دارد. این پرونده دوباره بحث مسئولیت توصیههای اشتباه هوش مصنوعی را جدی کرده است.
دیدگاهها
اولین نفری باش که دیدگاه میذاره