

هوش مصنوعی
Qwen4-Max با زمینه یکمیلیونتوکنی و هزینه کمتر عرضه شد
علیبابا Qwen4-Max رو با زمینه یکمیلیونتوکنی و پشتیبانی مستقیم از تصویر عرضه کرده. طبق آزمون داخلی شرکت، این مدل با توکن و هزینه کمتری از پس وظایف تخصصی برمیاد.
آرشیو
خبرها، تحلیلها و تجربههای فنی را سریع پیدا کن؛ بدون شلوغی و فهرستهای طولانی.
نتایج
علیبابا Qwen4-Max رو با زمینه یکمیلیونتوکنی و پشتیبانی مستقیم از تصویر عرضه کرده. طبق آزمون داخلی شرکت، این مدل با توکن و هزینه کمتری از پس وظایف تخصصی برمیاد.
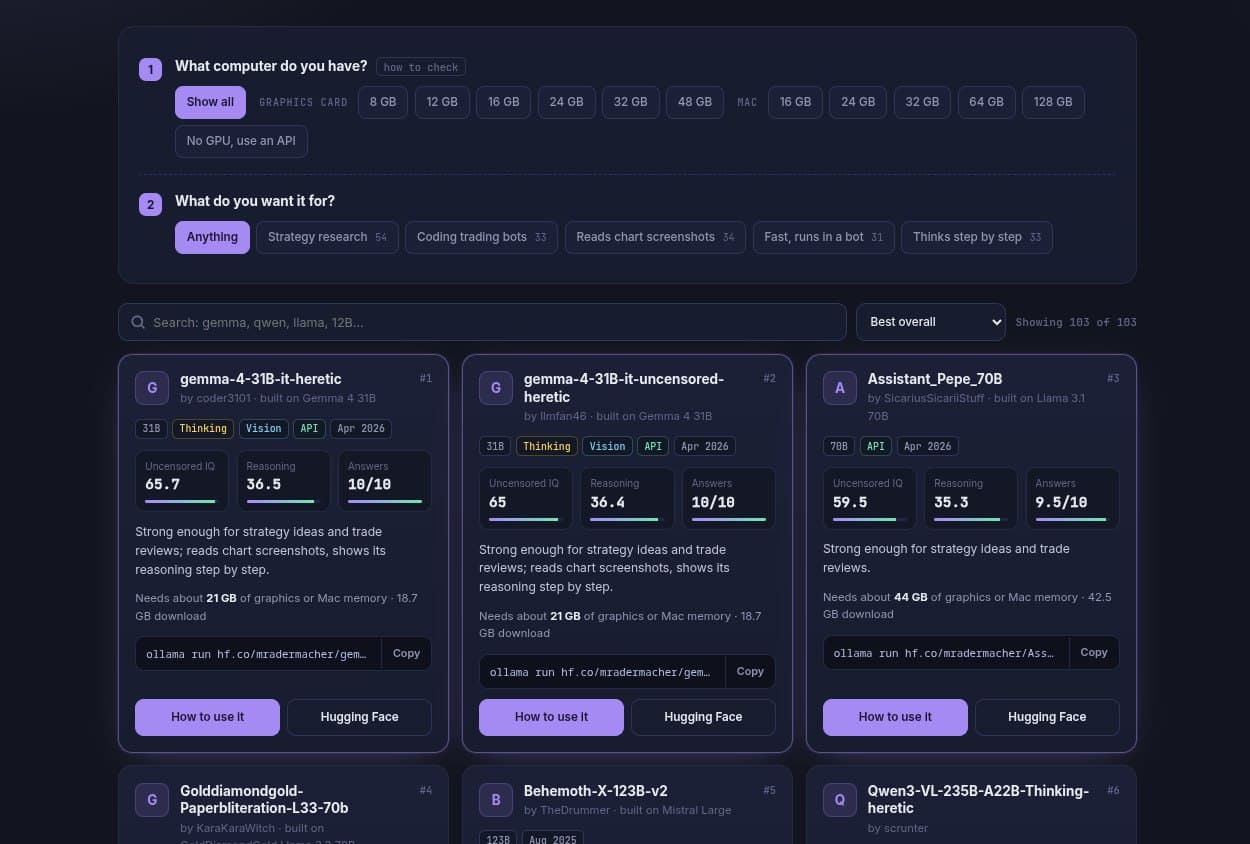
این سایت ۱۰۳ مدل بدون سانسور را بر اساس سختافزار دستهبندی کرده است. مدلها را میشود با Ollama دانلود کرد و روی کامپیوتر خودتان اجرا کرد.
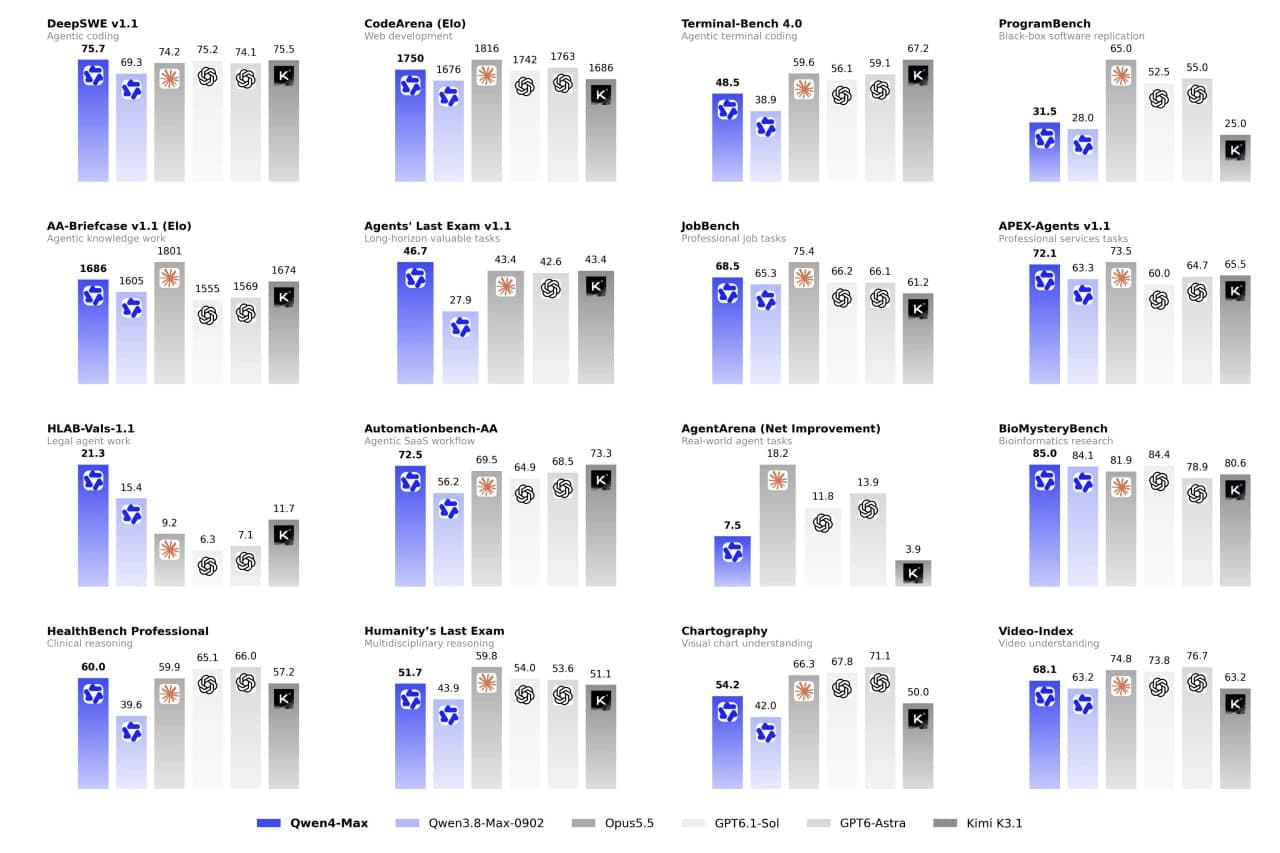
علیبابا Qwen4-Max را برای کارهای حرفهای، خلاقانه و پژوهشی معرفی کرده است. این شرکت از مصرف توکن و هزینه کمتر میگوید، اما جزئیات ارزیابیهایش هنوز در دسترس نیست.
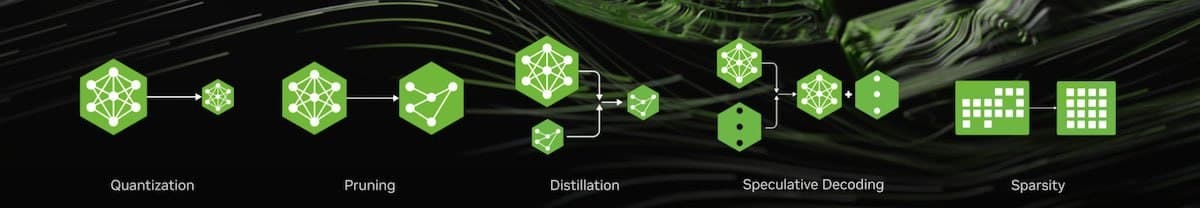
انویدیا نسخهای ۴ بیتی از Kimi-K3.1-Pro منتشر کرده که برای ذخیرهسازی و اجرا به منابع کمتری نیاز دارد. بااینحال، هنوز بنچمارک و جزئیات سختافزاری آن در دسترس نیست.
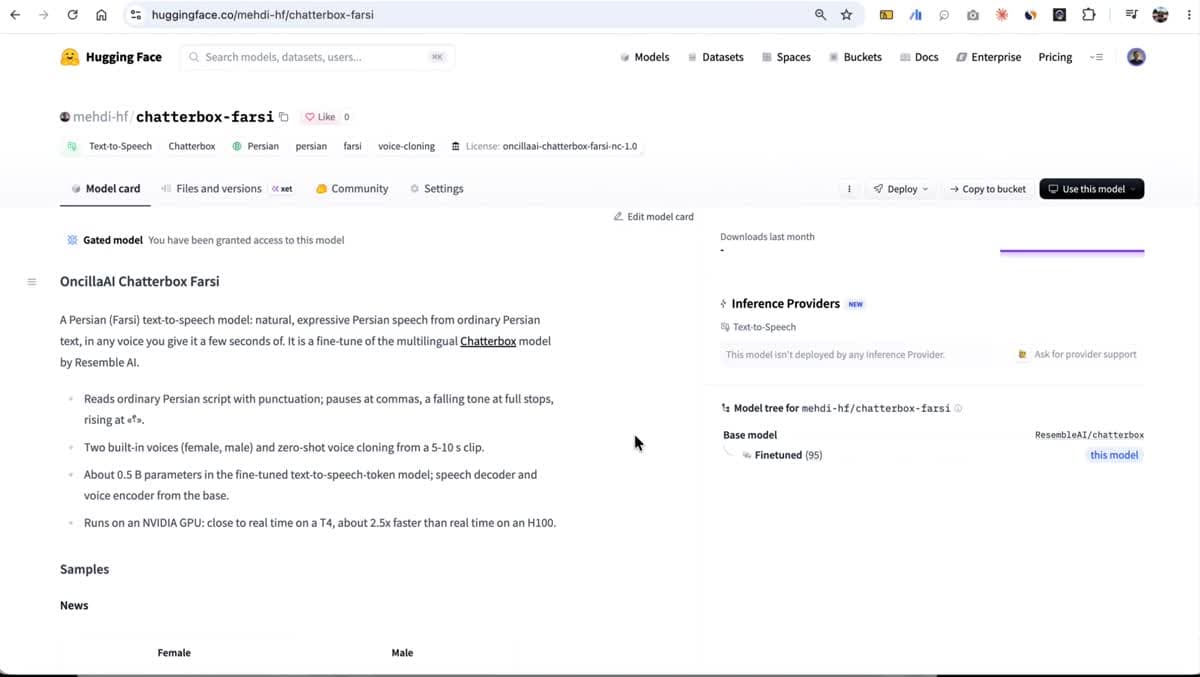
Chatterbox Farsi متن فارسی را با توجه به لحن و نقطهگذاری میخواند و با چند ثانیه نمونه صوتی، صدای گوینده را بازسازی میکند. این مدل دو صدای آماده زن و مرد هم دارد.
Hightouch با سپردن موارد مبهم Jev به Claude Opus، به دقتی نزدیک به Opus رسید. هزینه این روش برای هر هزار قضاوت ۰٫۸۸ دلار بود؛ کمتر از یکچهارم هزینه استفاده مستقیم از Opus.
QIQ یک مدل Qwen3.5-0.6B را داخل Qwen3.5-4B کامپایل کرده؛ محاسبه فقط یک توکن داخلی در حالت عادی حدود ۱٫۱ سال زمان میبرد، اما نتیجه بهینهشده با اجرای واقعی هم تأیید شده است.
میگن آنتروپیک یک مدل داخلی تازه دارد که در تمام ۱۵ بنچمارک METR امتیاز بالای ۵۰ درصد گرفته. فعلاً نه آنتروپیک تأییدش کرده و نه نام مدل رسماً اعلام شده، پس با یک شایعه طرفیم.
یک آزمایش جالب با GPT-6 Astra بهجای تولید کد، مستقیماً وزنهای چند شبکه عصبی کوچک برای بازی پونگ را ساخته. حتی تغییر یک نورون هنگام اجرای بازی، جهت حرکت توپ را عوض کرده است.
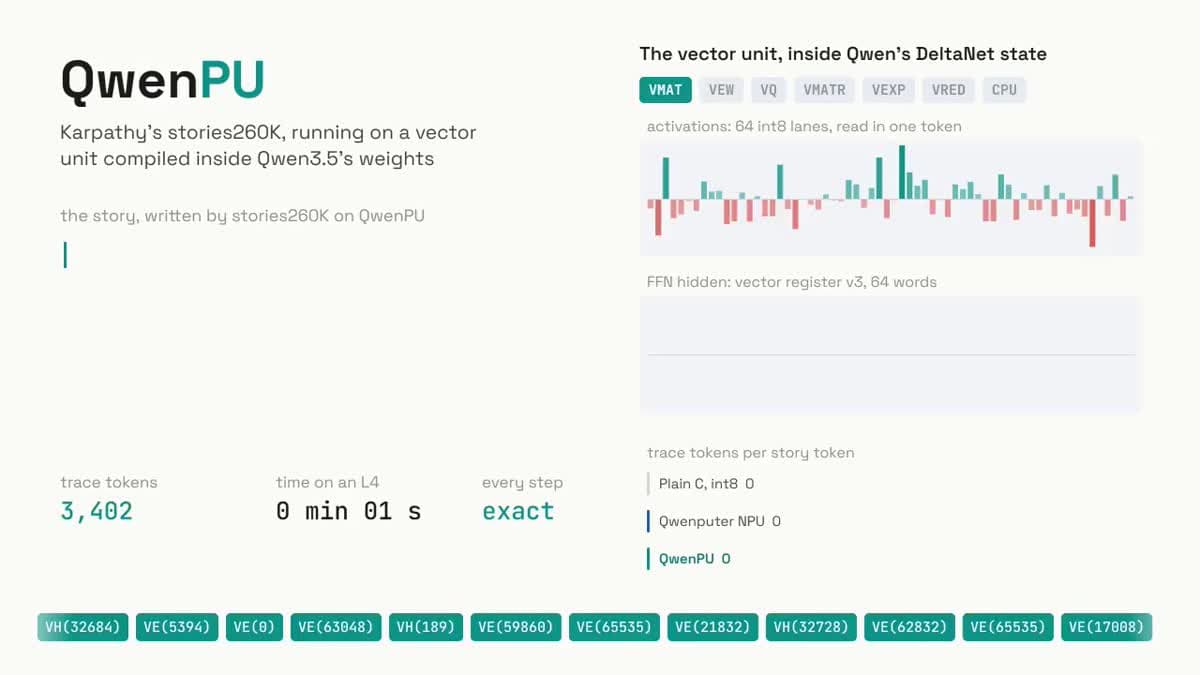
QwenPU یک مدل زبانی را روی NPUای اجرا میکند که داخل وزنهای Qwen 3.5-4B کامپایل شده؛ یعنی با نمونهای جالب از اجرای یک LLM درون LLM دیگر روبهرو هستیم.