۵ ابزار متنباز برای خواندن PDF و اسناد با هوش مصنوعی
Docling، Marker، Unstructured، MinerU و PaddleOCR پنج پروژه متنباز برای استخراج، ساختاردهی و آمادهسازی اسناد در سامانههای هوش مصنوعی هستند.
فهرست مطالب5 بخش
اگر میخواهید یک سامانه هوش مصنوعی بتواند PDFها، اسناد اسکنشده و فایلهای پیچیده را بخواند، ابتدا باید محتوای آنها را به دادهای ساختاریافته و قابل پردازش تبدیل کنید. در فهرست منتشرشده از ابزارهای پردازش سند، پنج پروژه متنباز معرفی شدهاند که هرکدام بخشی از این مسیر را سادهتر میکنند.
#نکات کلیدی
- Docling برای استخراج ساختار سند و آمادهسازی آن برای هوش مصنوعی مناسب است.
- Marker فایلهای PDF را به Markdown، JSON و قالبهای دیگر تبدیل میکند.
- Unstructured محتوای انواع فایل را برای RAG و جستوجوی اسناد آماده میکند.
- MinerU برای اسناد علمی و صفحات پیچیده کاربرد دارد.
- PaddleOCR متن موجود در تصاویر و اسناد اسکنشده را استخراج میکند.
#پنج ابزار برای پنج نیاز متفاوت
پروژه Docling اسناد را تجزیه میکند و متن، جدولها، ترتیب خواندن، فرمولها و ساختار صفحه را در قالبی منسجم در اختیار شما میگذارد. این ابزار از قالبهای متنوعی مانند PDF، DOCX، PPTX، XLSX، HTML، EPUB، تصاویر، فایلهای صوتی، ایمیل و متن ساده پشتیبانی میکند و میتواند خروجیهایی مانند Markdown، HTML و JSON تولید کند.
Docling امکان اجرای محلی را نیز دارد؛ قابلیتی که برای پردازش دادههای حساس یا محیطهای جدا از اینترنت اهمیت پیدا میکند. این پروژه از OCR برای PDFهای اسکنشده و تصاویر پشتیبانی میکند و با ابزارها و چارچوبهایی مانند LangChain، LlamaIndex، Crew AI و Haystack یکپارچه میشود.
ابزار Marker انتخابی متمرکزتر برای تبدیل PDF به Markdown، JSON و قالبهای دیگر است. طبق یادداشت منتشرشده، این ابزار میتواند ساختار سند، جدولها و فرمولها را تشخیص دهد؛ بنابراین زمانی کاربرد دارد که میخواهید محتوای PDF را به فرمتی سادهتر و مناسبتر برای پردازش بعدی تبدیل کنید.
پروژه Unstructured برای استخراج محتوای فایلهایی مانند PDF، Word و HTML و تقسیم آن به بخشهای قابل پردازش طراحی شده است. این رویکرد برای ساخت سامانههای RAG و جستوجو در اسناد مفید است؛ یعنی زمانی که سیستم باید ابتدا بخشهای مرتبط یک مجموعه سند را پیدا کند و سپس بر پایه همان محتوا پاسخ دهد.
ابزار MinerU روی تبدیل اسناد پیچیده به محتوای ساختاریافته تمرکز دارد. این پروژه برای استخراج متن، جدولها، فرمولها و اجزای صفحاتی مناسب است که ساختار ساده و خطی ندارند؛ به همین دلیل در یادداشت، از آن بهعنوان گزینهای برای اسناد علمی و پیچیده نام برده شده است.
در نهایت، مجموعه PaddleOCR برای شناسایی متن داخل تصاویر و اسناد اسکنشده کاربرد دارد. اگر ورودی شما بهجای متن دیجیتال، تصویر یا اسکن باشد، OCR میتواند آن را به متن قابل جستوجو و پردازش تبدیل کند.
#کدام پروژه برای شما مناسبتر است؟
انتخاب ابزار به نوع فایل و خروجی موردنیاز شما بستگی دارد. این پنج پروژه الزاماً جایگزین مستقیم یکدیگر نیستند و هرکدام مسئله متفاوتی را هدف گرفتهاند:
- برای پردازش عمومی اسناد و حفظ ساختار صفحه: Docling
- برای تبدیل مستقیم PDF به Markdown: Marker
- برای آمادهسازی انواع فایل در سامانههای RAG: Unstructured
- برای استخراج محتوای اسناد علمی و پیچیده: MinerU
- برای خواندن متن تصاویر و اسکنها: PaddleOCR
این ابزارها میتوانند بخشی از زیرساخت یک AI Agent باشند؛ برای نمونه، ایجنتی که مجموعهای از PDFها را میخواند، اطلاعات موردنیاز را در آنها پیدا میکند و پاسخ خود را بر اساس محتوای واقعی اسناد میسازد. تفاوت اصلی در این است که هر ابزار چگونه فایل اولیه را تحلیل و برای مرحله بعد آماده میکند.
#نکته مهم درباره اسناد فارسی
اگر با اسناد فارسی سروکار دارید، صرف پشتیبانی یک ابزار از OCR برای تصمیمگیری کافی نیست. کیفیت تشخیص حروف فارسی، ترتیب راستبهچپ، جدولها، فرمولها و چیدمان واقعی صفحه باید روی چند فایل نمونه از مجموعه خودتان آزمایش شود.
بهتر است پیش از انتخاب نهایی، خروجی ابزارها را با همان نوع سندی مقایسه کنید که قرار است در پروژه واقعی پردازش شود. چنین آزمایشی به شما نشان میدهد کدام گزینه ساختار و متن فارسی را دقیقتر و با نیاز سامانهتان هماهنگتر حفظ میکند.
#جمعبندی
برای ساخت هوش مصنوعی متصل به اسناد، انتخاب ابزار مناسب از خود مدل زبانی کماهمیتتر نیست. اگر نیاز اصلیتان را مشخص کنید—از OCR و تبدیل PDF گرفته تا RAG و حفظ ساختار صفحات—میتوانید از میان این پنج پروژه گزینه مناسبتری را انتخاب و پیش از استفاده گسترده، آن را با اسناد واقعی خودتان ارزیابی کنید.
منابع خبر
- github.com — منبع اصلیhttps://github.com/docling-project/docling
- github.comhttps://github.com/datalab-to/marker
- github.comhttps://github.com/Unstructured-IO/unstructured
- github.comhttps://github.com/opendatalab/MinerU
- github.comhttps://github.com/PaddlePaddle/PaddleOCR
- x.comhttps://x.com/Yarad_ai/status/2113981775718330513?s=20
مطالب مرتبط
برای ادامه مطالعه
این یادداشتها بر اساس موضوع مشترک، همپوشانی برچسبها و تازگی انتشار انتخاب میشوند.
Loopcut؛ عامل هوش مصنوعی متنباز برای کار مستقیم در Blender
Loopcut یک نسخه متنباز از Blender است که عامل هوش مصنوعی را مستقیماً به محیط طراحی سهبعدی میآورد و اجرای دستورات فنی را با نظارت کاربر انجام میدهد.
۵ ابزار متنباز GitHub برای ردیابی خطاهای اپلیکیشنهای هوش مصنوعی
Langfuse، Phoenix، Helicone، OpenLLMetry و AgentOps پنج ابزار متنباز برای ردیابی درخواستها، ارزیابی مدلها و عیبیابی اپلیکیشنهای هوش مصنوعی هستند.
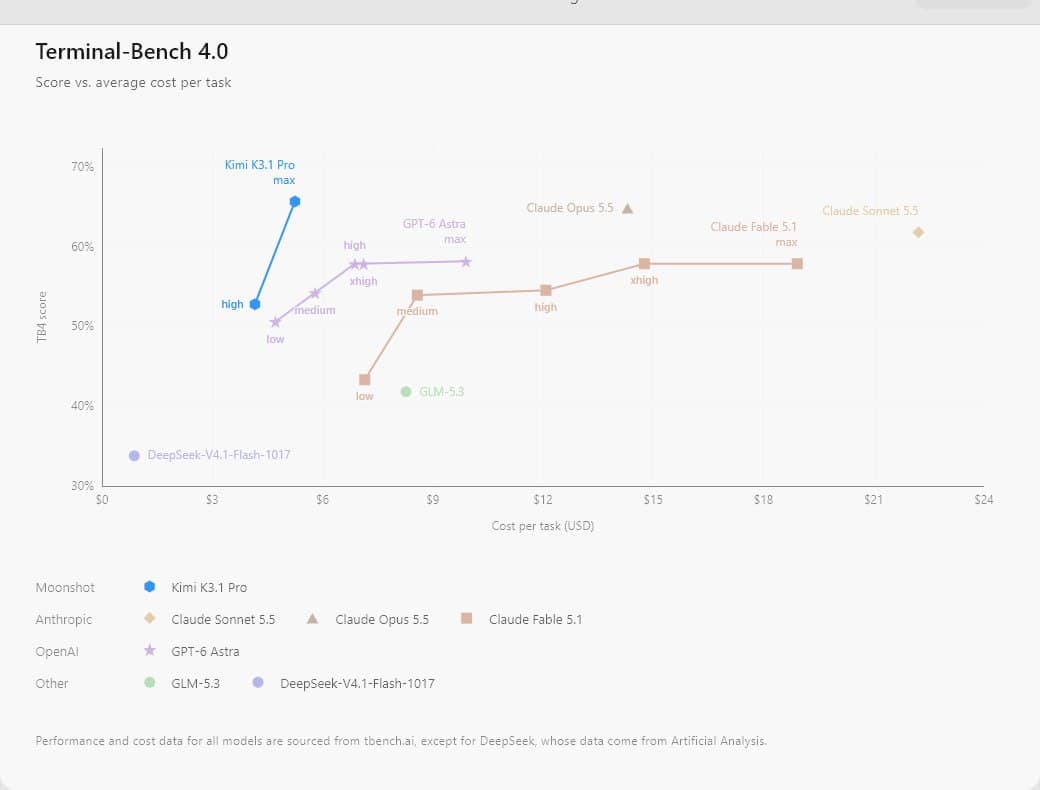
Kimi K3.1 Pro با پنجره یکمیلیون توکنی معرفی شد
Moonshot AI مدل چندوجهی Kimi K3.1 Pro را با ۲.۸ تریلیون پارامتر معرفی کرده است؛ مدلی که طبق اطلاعات منتشرشده، در چند بنچمارک عملکرد و هزینه رقابتی دارد.
دیدگاهها
اولین نفری باش که دیدگاه میذاره