

راهکار جدید انویدیا برای تسریع انتقال حافظه مکالمه میان مدلهای هوش مصنوعی
محققان انویدیا روشی معرفی کردهاند که با بهرهگیری از جبر خطی، انتقال KV Cache میان مدلهای هوش مصنوعی را سریعتر و کمهزینهتر میکند.
تهیهشده با کمک هوش مصنوعی از منابع ذکرشده
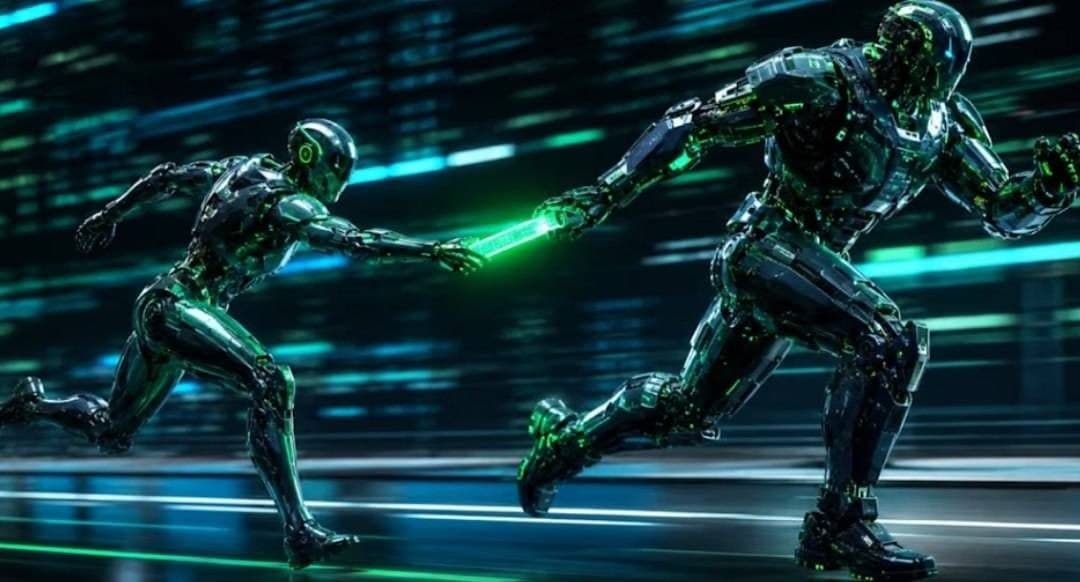
به گزارش ونچربیت، محققان انویدیا راهکاری ابداع کردهاند که انتقال حافظه مکالمه یا KV Cache میان مدلهای مختلف هوش مصنوعی را امکانپذیر میکند؛ قابلیتی که برای سیستمهای مبتنی بر جابهجایی میان مدلهای کوچک و بزرگ اهمیت دارد.
بر اساس این گزارش، در سیستمهای هوشمند، هنگام تغییر از یک مدل به مدلی دیگر، مدل جدید معمولاً ناچار است کل گفتوگو را از ابتدا بازسازی کند. این فرایند میتواند هزینهبر و زمانبر باشد، بهویژه زمانی که گفتوگو طولانیتر شود یا جابهجایی میان مدلها دفعات بیشتری رخ دهد.
روش جدید انویدیا بهجای تکیه بر فرایندهای سنگین یادگیری، از محاسبات ساده مبتنی بر جبر خطی استفاده میکند. طبق یادداشت منتشرشده، این رویکرد توانسته است عملیات انتقال را بین ۲.۷ تا ۲۵ برابر سریعتر کند و هزینهها را بهشدت کاهش دهد.
این دستاورد، در صورت بهکارگیری در سامانههای هوش مصنوعی، میتواند مسیر استفاده کارآمدتر از مدلهای کوچک و بزرگ را هموار کند؛ بدون آنکه در هر جابهجایی، بازسازی کامل تاریخچه گفتوگو لازم باشد.
مطالب مرتبط
برای ادامه مطالعه
این یادداشتها بر اساس موضوع مشترک، همپوشانی برچسبها و تازگی انتشار انتخاب میشوند.
Qwen4-Max با زمینه یکمیلیونتوکنی و هزینه کمتر عرضه شد
علیبابا Qwen4-Max رو با زمینه یکمیلیونتوکنی و پشتیبانی مستقیم از تصویر عرضه کرده. طبق آزمون داخلی شرکت، این مدل با توکن و هزینه کمتری از پس وظایف تخصصی برمیاد.
دیدگاهها
اولین نفری باش که دیدگاه میذاره
دیدگاهها پس از بررسی منتشر میشوند. ایمیل شما نمایش داده نمیشود.