

Chatterbox Farsi؛ گفتار فارسی طبیعی با چند ثانیه صدا
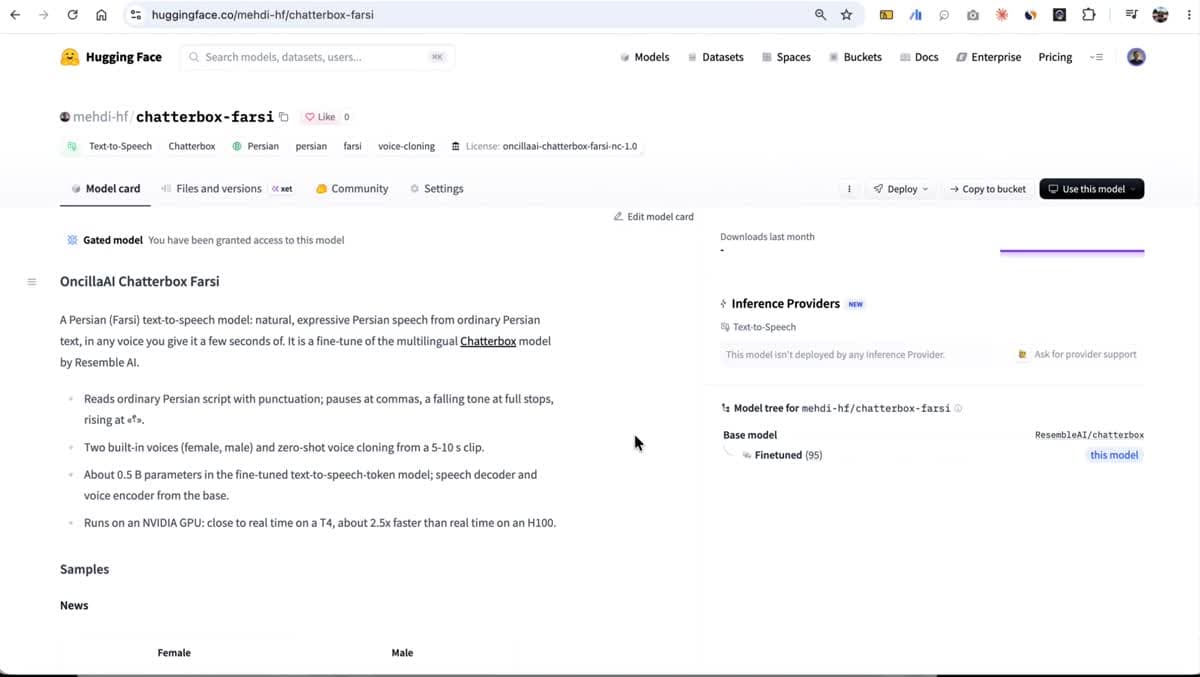
Chatterbox Farsi متن فارسی را با توجه به لحن و نقطهگذاری میخواند و با چند ثانیه نمونه صوتی، صدای گوینده را بازسازی میکند. این مدل دو صدای آماده زن و مرد هم دارد.
تهیهشده با کمک هوش مصنوعی از منابع ذکرشده
فهرست مطالب۴ بخش
مدل تبدیل متن به گفتار Chatterbox Farsi با هدف تولید صدای طبیعی و بیانگر فارسی منتشر شده است. این مدل متن فارسی را مستقیم میخواند، به نشانهگذاری واکنش نشان میدهد و میتواند با دریافت ۵ تا ۱۰ ثانیه صدای مرجع، صدای یک گوینده را شبیهسازی کند.
#نکات کلیدی
- متن فارسی معمولی را مستقیماً میخواند و به نقطهگذاری واکنش نشان میدهد.
- با نمونهای حدود ۵ تا ۱۰ ثانیهای میتواند صدای یک فرد را شبیهسازی کند.
- دو صدای آماده زن و مرد همراه مدل ارائه شده است.
- نمونههایی از متنهای خبری، آموزشی، داستانی، محاورهای، هیجانی و پرسشی برای مدل منتشر شده است.
- استفاده از مدل به پذیرش مجوز غیرتجاری اختصاصی آن نیاز دارد.
#خواندن فارسی با مکث و آهنگ جمله
Chatterbox Farsi پس از مدل سبکتر Pocket TTS فارسی معرفی شده، اما سازنده میگوید این بار تمرکز اصلی بر کیفیت و طبیعیبودن صدا بوده است. مدل در محل ویرگول مکث میکند، در پایان جمله لحن را پایین میآورد و جملههای پرسشی را با آهنگ سؤال میخواند.
نمونههای منتشرشده خبر، دستورالعمل، داستان، اسامی خاص، گفتوگوی محاورهای و جملههای هیجانی را در بر میگیرند. صفحه Chatterbox Farsi در Hugging Face این مدل را نسخهای تنظیمشده از مدل چندزبانه Chatterbox شرکت Resemble AI معرفی میکند.
یکی از جزئیات مهم در خواندن فارسی، «اضافه» است؛ صدای کوتاهی که در ترکیبهایی مانند «کتابِ من» شنیده میشود، اما معمولاً در نوشتار علامت نمیخورد. کاربر میتواند با نوشتن کسره، خواندن اضافه را مشخص کند و با قرار دادن ویرگول، مانع اضافه ناخواسته شود. طبق ارزیابی منتشرشده در صفحه مدل، اضافه در ۳۹ مورد از ۴۰ کلیپ صدای زن و هر ۳۲ کلیپ صدای مرد درست خوانده شده است.
#شبیهسازی صدا با یک نمونه کوتاه
برای شبیهسازی صدا میتوان یک کلیپ مرجع کوتاه در اختیار مدل گذاشت. معرفی عمومی مدل نمونهای ۵ تا ۱۰ ثانیهای را پیشنهاد میکند و در توضیحات فنی نیز از استفاده از ۱۵۰ توکن گفتاری، معادل حدود ۶ ثانیه صدا، برای شرطیسازی نام برده شده است.
در صورت استفادهنکردن از صدای مرجع، دو صدای آماده زن و مرد در دسترس است. برای استفاده از صدای اشخاص، بهویژه در محتوای عمومی، دریافت رضایت صاحب صدا ضروری است.
مدل خروجی تککاناله با نرخ نمونهبرداری ۲۴ کیلوهرتز تولید میکند و سقف هر بار تولید حدود ۴۰ ثانیه، معادل هزار توکن گفتاری، اعلام شده است. فایل وزن بخش تنظیمشده نیز در قالب float32 حدود ۲٫۱ گیگابایت حجم دارد. طبق معرفی مهدی اللهیاری از Chatterbox Farsi، تولید صدا روی کارتهای گرافیک انویدیا تقریباً همزمان با پخش انجام میشود و کارتهای قویتر میتوانند سریعتر از زمان واقعی خروجی بگیرند.
#اجرای مدل و شرایط استفاده
Chatterbox Farsi با کتابخانه Chatterbox اجرا میشود و راهاندازی آن به مدل پایه Resemble AI و وزن فارسی نیاز دارد. متن با خط فارسی و از طریق توکنساز چندزبانه مدل پردازش میشود و سامانه به مبدل جداگانه متن به واج متکی نیست. نقطهگذاری، نیمفاصله و نشانههای اضافه نیز در ورودی حفظ میشوند.
مخزن مدل عمومی است، اما دریافت فایلهای آن به پذیرش مجوز غیرتجاری OncillaAI Chatterbox Farsi نسخه ۱٫۰ نیاز دارد. شرایط اعلامشده شامل این موارد است:
- مدل فقط برای استفاده غیرتجاری مجوز دارد.
- استفاده از مدل یا خروجی آن برای آموزش، تقطیر یا بهبود مدل دیگری مجاز نیست.
- در استفاده عمومی باید عبارت «Powered by OncillaAI Chatterbox Farsi» نمایش داده شود.
- برای استفاده تجاری باید با ارائهدهنده مدل تماس گرفت.
نحوه نوشتن متن هم بر خروجی اثر میگذارد. نقطهگذاری، نیمفاصله و علامتگذاری اضافه میتوانند مکث و تلفظ را تغییر دهند؛ بنابراین آزمایش نگارشهای مختلف و گزارش تلفظهای نادرست میتواند برای نسخههای بعدی مدل مفید باشد.
مطالب مرتبط
برای ادامه مطالعه
این یادداشتها بر اساس موضوع مشترک، همپوشانی برچسبها و تازگی انتشار انتخاب میشوند.
Live Dictation چتجیپیتی، صدا را همزمان به متن تبدیل میکند
با Live Dictation، متن همزمان با صحبتکردن ظاهر میشود و نیازی نیست تا پایان ضبط صبر کنید. محدودیت ۱۰ دقیقهای ضبط هم حذف شده است.
دیدگاهها
اولین نفری باش که دیدگاه میذاره
دیدگاهها پس از بررسی منتشر میشوند. ایمیل شما نمایش داده نمیشود.