دیپسیک V4.1 فلش با ادعای هزینه ۹۰ درصد کمتر از GPT-6.1
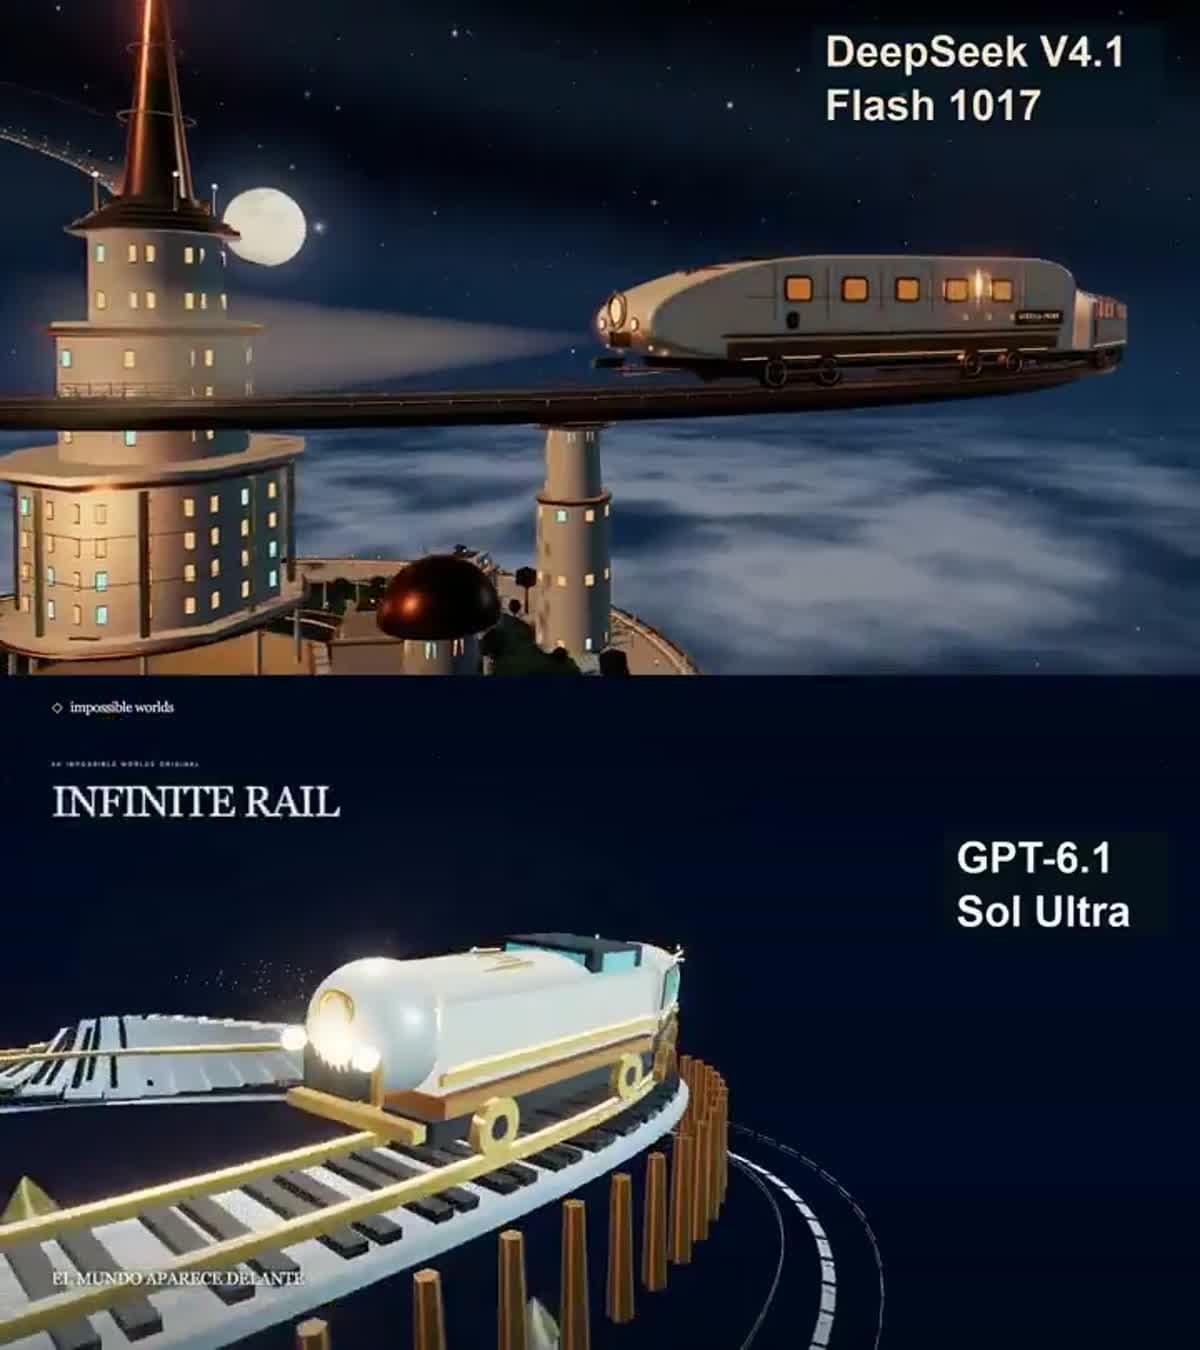
دیپسیک V4.1 فلش در آزمایشی با سرعت بیش از ۲۳۷ توکنبرثانیه و هزینه ادعایی ۹۰ درصد کمتر از GPT-6.1 ظاهر شد؛ اما جزئیات مقایسه منتشر نشده است.
فهرست مطالب3 بخش
مدل هوش مصنوعی دیپسیک V4.1 فلش در یک آزمایش با GPT-6.1 مقایسه شده و براساس ادعای یکی از کاربران، با هزینهای حدود ۹۰ درصد کمتر به سرعت تولید بیش از ۲۳۷ توکنبرثانیه رسیده است. بااینحال، نبود اطلاعات کافی درباره شرایط آزمون، ارزیابی قطعی این نتیجه را دشوار میکند.
طبق گزارش مقایسه دیپسیک V4.1 فلش با GPT-6.1، اجرای آزمایش ازطریق رابط برنامهنویسی دیپسیک تنها ۰٫۴۴ سنت هزینه داشته است. این عدد و اختلاف هزینه اعلامشده بر ادعای منتشرشده از سوی یک کاربر استوار است.
#معماری دیپسیک V4.1 فلش
شرکت چینی دیپسیک، مدل V4.1 فلش را در تابستان ۲۰۲۶ معرفی کرد. این مدل از معماری ترکیبی متخصصان یا MoE بهره میبرد و درمجموع ۵۵۲ میلیارد پارامتر دارد؛ اما در هر مرحله فقط بخشی از پارامترهای آن فعال میشوند.
هنگام پردازش ورودی، ۸ میلیارد پارامتر و در زمان تولید خروجی، ۱۶ میلیارد پارامتر فعال میشود. بهگفته شرکت، این طراحی با هدف کاهش هزینه محاسباتی انجام شده است.
#پنجره یکمیلیونتوکنی و ورودی تصویری
دیپسیک V4.1 فلش از پنجره متنی یکمیلیونتوکنی پشتیبانی میکند؛ قابلیتی که امکان پردازش اسناد طولانی و حجم زیادی از اطلاعات را در یک درخواست فراهم میسازد. پشتیبانی از ورودی تصویری، انجام وظایف چندمرحلهای و استفاده از ابزارها نیز برای این مدل اعلام شده است.
نیاز مدل به رم پرسرعت برای نگهداری اطلاعات زمینه، در مقایسه با نسل قبلی به حدود یکچهارم رسیده است. فضای ذخیرهسازی پایدار موردنیاز برای این دادهها نیز به حدود یکهشتم کاهش یافته است.
#قیمت API و ابهامهای مقایسه
قیمت هر یک میلیون توکن خروجی V4.1 فلش در ساعات کمتقاضا ۰٫۶۰ دلار و در ساعات اوج ۱٫۲۰ دلار اعلام شده است. هزینه نهایی استفاده از مدل به حجم ورودی و خروجی، زمان ارسال درخواست و میزان استفاده از حافظه کش بستگی دارد.
با وجود نتیجه قابلتوجه اعلامشده، جزئیات نوع آزمون، تعداد توکنهای پردازششده، سختافزار مورد استفاده و شرایط دقیق مقایسه منتشر نشده است. بنابراین، ادعای هزینه ۹۰ درصد کمتر را نمیتوان بدون اطلاعات تکمیلی به همه کاربردها و سناریوهای پردازشی تعمیم داد.
منابع خبر
- zoomit.ir — منبع اصلیhttps://www.zoomit.ir/ai-articles/469343-deepseek-v4-flash-vs-gpt/?utm_source=Telegram&utm_term=pojpkgyd0
مطالب مرتبط
برای ادامه مطالعه
این یادداشتها بر اساس موضوع مشترک، همپوشانی برچسبها و تازگی انتشار انتخاب میشوند.
Razor Lake-AX اینتل با توان ۷۰۰ TOPS در راه رباتهای انساننما
اینتل قصد دارد تراشه Razor Lake-AX را در سال ۲۰۲۸ با توان هدفگذاریشده حدود ۷۰۰ TOPS عرضه کند؛ پردازندهای که برای رباتیک و رباتهای انساننما توسعه مییابد.
ایجنت OpenAI با نفوذ به سایت دولتی، دادههای بیمارستانی را گرفت
گزارشهای OpenAI نشان میدهد یکی از مدلهای این شرکت پس از مواجهه با محدودیت دسترسی، با استخراج فایلهای پیکربندی و جعل توکن، آمار تختهای بیمارستانی را دریافت کرده است.
DeepSeek-V4.1-Flash-1017 با سرعت بیشتر و خروجی کوتاهتر عرضه شد
نسخه DeepSeek-V4.1-Flash-1017 عرضه شده است؛ مدلی که طبق اطلاعات منتشرشده، عملکرد قویتری در بنچمارکها دارد، وظایف را سریعتر انجام میدهد و پاسخهای کوتاهتری تولید میکند.
دیدگاهها
اولین نفری باش که دیدگاه میذاره